
7nm FinFET 單晶片整合 6.4 Tb/s CPO ASIC:直驅 TIA 與分段式 MZM 驅動器設計解析

AI 運算叢集對晶片間頻寬的需求持續攀升,傳統插拔式光模組在功耗與密度上已逼近瓶頸,光電共封裝(CPO)成為下一步的整合方向。這篇研究展示 Broadcom 以 7nm FinFET 製程打造的 6.4 Tb/s 重定時 ASIC, 組成 51.2 Tb/s 的 CPO 系統,是目前文獻中整合度最高的設計。
CPO 架構與晶片定位
光電共封裝透過將光電子晶片(PIC)與網路 ASIC 緊密共置,大幅縮短晶片間電氣互連長度,藉此降低訊號完整性問題與功耗。本文介紹的晶片單片整合 64 條 Egress(TX)通道與 64 條 Ingress(RX)通道,每條通道資料速率均為 106.25 Gb/s PAM-4,並整合 320 路監控光二極體讀出線路、320 路加熱器 DAC,以及完整時脈產生與數位訊號處理架構。8 顆這樣的光電引擎共封裝後,即可組成 51.2 Tb/s 的 CPO 系統。
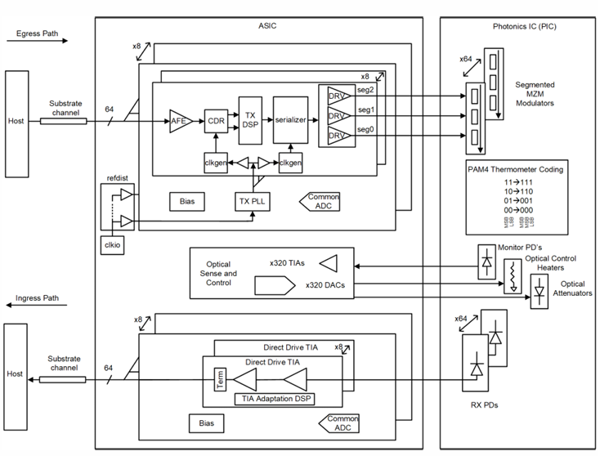
圖 1:6.4 Tb/s CPO ASIC 的頂層方塊圖,顯示 Egress 路徑(TX)與 Ingress 路徑(RX)分別透過有機基板連接至主機網路 ASIC,以及透過 3D 封裝連接至共封裝的光電子晶片(PIC);PIC 上配置 64 個分段式 MZM 用於 TX,以及 64 個光二極體用於 RX。
Egress 路徑:主機端類比前端與時脈資料恢復
Egress 路徑負責接收主機網路 ASIC 的 PAM-4 資料,以低抖動時脈重定時,再交由 MZM 驅動器傳送。輸入訊號經電容耦合進入連續時間線性均衡器(CTLE),耦合路徑配置精密校準終端電阻與頻寬延伸用的 T 型線圈,抵消 ESD 保護元件寄生電容對頻寬的影響;CTLE 輸出驅動可變增益放大器(VGA),再進入 4 倍時間交錯取樣器。4 個取樣相位由 TX PLL 時脈透過基於 DLL 的正交時脈產生器(IQgen)與相位內插器(PI)衍生而來,取樣結果送入 TX DSP 執行完整的時脈資料恢復(CDR),並透過 16 個 9-bit DAC 動態調整 PAM-4 閾值電位。

圖 2:Egress 路徑主機端詳細方塊圖,涵蓋 CTLE、VGA、4 倍時間交錯取樣器、基於 DLL 的 IQgen/PI 時脈鏈、解串器,以及包含 CDR 自適應與 PAM-4 閾值控制的 TX DSP。
Egress 路徑:分段式 MZM 驅動器
TX DSP 完成重定時後,資料經線路端串列器轉換,分別送往 MZM 的 3 個驅動器段。第 0 段驅動 LSB,第 1、2 段驅動 MSB,採溫度計編碼的 PAM-4 驅動方案,讓兩個 MSB 段可同時驅動,改善調變線性度。每段內建獨立本地時脈產生線路,修正時脈分配路徑的失真;4:1 多工器輸出經兩級電平移位預驅動器轉為 1.5V NRZ 訊號,驅動疊接式 PMOS/NMOS 輸出級,偏壓與共源共柵電壓均由每段內置的 LDO 與專用 DAC 獨立產生,用於精細控制驅動擺幅與共模電位,這對驅動矽光子 MOSCAP 分段調變器維持高線性度是必要的設計。

圖 3:Egress 路徑線路端方塊圖,包含串列器鏈、各段本地 IQgen 時脈產生,以及具備疊接輸出級與電平移位預驅動器的 3 段式 MZM 驅動器,輸出 1.5V NRZ 驅動訊號。
Ingress 路徑:直驅式跨阻放大器
Ingress 路徑採直驅架構,TIA 差分輸出直接透過有機基板驅動主機網路 ASIC,省去限幅放大器或重定時器,簡化訊號鏈並降低延遲,但也對 TIA 的雜訊、頻寬與增益平坦度提出嚴格要求。光二極體陽極連接電流轉電壓(i2v)轉換級,輸入端串聯電感與寄生電容形成並聯諧振以延伸頻寬;i2v 核心以 CMOS 反相器為基礎,搭配回授電阻與受控偏置電流穩定工作點。訊號經 VGA1 轉為全差動格式,再經 VGA2、VGA3 至輸出驅動器,均搭配 T 型線圈與可調負載電阻優化頻寬。每條通道配置本地 DSP,透過 VGA 增益控制碼閉合振幅調節迴路,並驅動 TIA 輸入端的 DC 消除電路。整體 TIA 輸入參考電流雜訊密度為 15 pA/√Hz,每通道功耗低於 50 mW。

圖 4:Ingress 路徑直驅式 TIA 方塊圖,顯示輸入電感 Lin 帶寬延伸、具回授電阻 Rfb 的 i2v 轉換級、偽差動轉全差動(VGA1)、VGA2/VGA3 T 型線圈帶寬優化、具 5-bit 終端校準的輸出驅動器,以及含 DC 消除與自適應前端的本地 DSP。
系統效能驗證
系統層級驗證橫跨完整 51.2 Tb/s CPO 平台的所有 512 條通道,運行於 4 個 WDM 波長(1271、1291、1311、1331 nm)。實際量測結果:- 直驅 TIA 靈敏度:在前 FEC BER 門檻 2.4×10⁻⁴ 條件下,平均優於 −11 dBm;- BER 誤差底:優於 1×10⁻⁹;- Egress 傳輸品質:超過 99.98% 通道達到前 FEC BER 優於 1×10⁻⁹,實際上為無誤差傳輸;- 光眼圖指標:TDEQ 1.48 dB、外側消光比 4.57 dB、RLM 0.958,均符合 IEEE 802.3bs 標準規範。與文獻已報告的最佳光學介面收發器相比,本設計以 4.2 pJ/b 的能量效率,實現最高的單晶片總吞吐量與通道數。
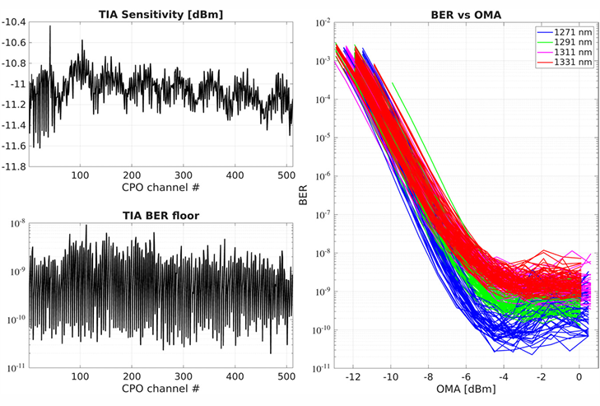
圖 5:在 51.2 Tb/s CPO 系統的 512 條通道上量測所得的直驅 TIA 靈敏度分佈(左)及 BER 對輸入光學調變幅度(OMA)曲線(右),結果涵蓋 4 個 WDM 波長,驗證平均靈敏度優於 −11 dBm、BER Floor 優於 1×10⁻⁹。

圖 6:(左)106.25 Gb/s PAM-4 光眼圖,TDEQ 1.48 dB、消光比 4.57 dB;(中)TX DSP 內部 CDR 眼圖掃描,顯示清晰張開的 PAM-4 眼圖;(右)與最新文獻比較表,本設計以 4.2 pJ/b 能量效率實現最高通道數與總吞吐量。
晶片實體與應用意義
6.4 Tb/s CPO ASIC 以 7nm FinFET 製程製造,單片整合 64 條 Egress 通道、64 條 Ingress 通道、多組 TX PLL 及週邊 ADC/DAC 元件,晶片佈局採 4 區塊對稱排列,TX、RX 通道各分為兩組 32 通道區塊。多顆這樣的光電引擎透過 3D 封裝與矽光子 PIC 疊合,再與主機網路 ASIC 共封裝,構成總吞吐量達 51.2 Tb/s 以上的可擴展 CPO 系統,展示了高度整合的電子 ASIC 作為多 terabit 光電引擎重定時與驅動骨幹的可行性,能同時滿足下一代 AI 網路基礎設施對功耗、靈敏度與訊號品質的要求。

圖 7:6.4 Tb/s CPO ASIC 晶片照片(7nm FinFET),標註顯示對稱排列的 4 組通道區塊,分別為 2 組 32 路 TX 與 2 組 32 路 RX 通道。
參考文獻
1. M. Kashmiri, A. Yadav, J. Namkoong, B. Nakhkoob, T. Kao, S. Shen, V. Pandey, K.-C. Chen, J. Han, S. Gaddam, S. Kazemkhani, S. Y. Kim, S. Maangat, B. Nguyen, M. Robinson, and H. Hedayati, "A 6.4Tb/s 4.2pJ/b Co-Packaged Optics ASIC with Direct-Drive Integrated TIA and Retimed Segmented Mach-Zehnder Modulator Driver in 7nm FinFET," in IEEE International Solid-State Circuits Conference (ISSCC), San Francisco, CA, USA, Feb. 2026, pp. 402–403.


Comments